爬山虎采集器软件为网页资源下载服务,将多种类型的文件整合在软件中,在网页中去下载文件,为用户提供自动化操作服务,线上去采集不同的信息和数据内容。帮助好去随时插曲自己需要的资源,享受软件带来的优质服务。在不同的设备中都可以使用,有完全的自动化操作,为用户提供定期运行和自动发布,调整自己的参数去进行使用,满足用户的需求,解决用户的使用需求。
1️⃣ 爬山虎采集器软件介绍
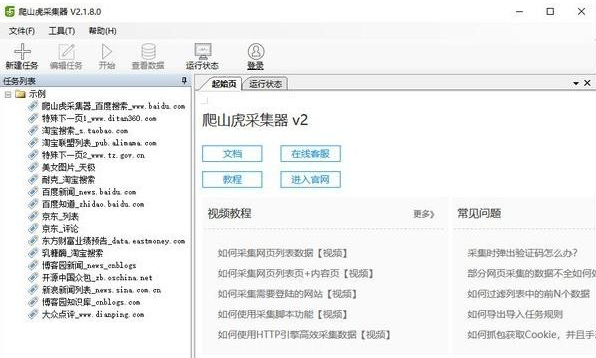
爬山虎采集器这是一款简单易用的网页数据采集工具,能够从几乎所有网站收集数据,包括网页表格、文档、图片以及各种其他类型的文件。
它可批量自动将数据下载到本地计算机。此外,采集过程快速高效,支持导出为多种格式,如表格、文本、数据库和网站API等。
同时,Tiger Web Scraper 可设置定期运行,自动发布并实现增量更新。该工具完全实现自动化操作,无需人工干预,显著提升了人们从互联网获取数据的效率。
2️⃣ 爬山虎采集器软件功能
1. 自动数据导出
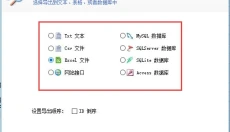
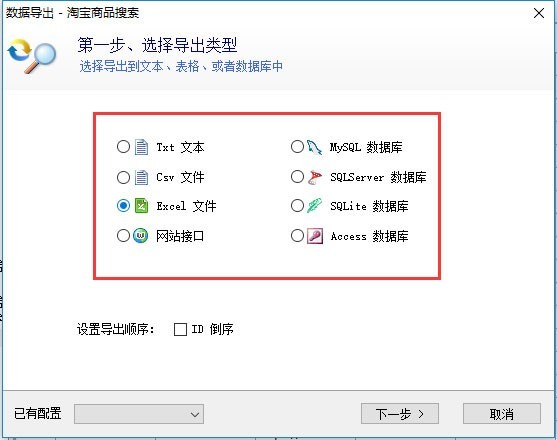
可自动导出并发布数据,支持多种格式,如TXT、CSV、Excel、Access、MySQL、SQL Server、SQLite和API。
2. 高速采集
内置高效的浏览器引擎、HTTP 引擎和 JSON 引擎。通过高度优化的内核和多线程采集技术,速度非常快。
3. 批处理文件下载
可自动下载图片、PDF、docx 等文件,并支持自定义保存目录和文件名。
4. 增量更新
通过定期操作和增量更新,可以实现采集任务的完全自动化,并实时监控目标网站,从而实现同步更新。
3️⃣ 爬山虎采集器软件特点
1. 引导模式
通过可视化界面和鼠标点击,即可收集数据。引导模式使用户无需任何技术背景也能提取数据,只需输入网站地址,一键即可完成数据提取。
2. 独特的高速内核
它包含一组高速浏览器内核,以及HTTP引擎和JSON引擎模式,可实现快速的数据采集。
3. 计划执行
可设置为每分钟、每天、每周运行,或根据CRON表达式执行。一旦指定计划任务,该任务便能自动收集和发布数据,无需人工干预。
4. 智能识别
通过智能算法,可自动识别分页和列表,并实现一键数据采集。
5. 文件下载支持
支持下载图片、视频和文档等各种文件,同时支持自定义保存路径和文件名。
6. 支持多种数据导出格式,
包括TXT、CSV、Excel、ACCESS、MySQL、SQL Server、SQLite,以及发布到网站接口(API)。
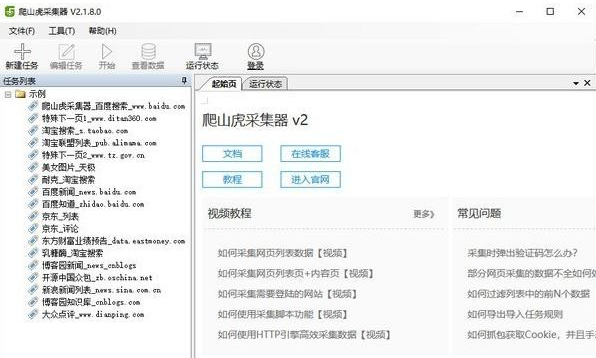
4️⃣ 爬山虎采集器软件亮点
定时采集:设置定时任务,例如每隔几小时采集一次数据,之后将自动运行。
增量更新:可自动识别并仅采集新增或更新的内容,避免重复采集,节省时间和资源。
文件下载:不仅能采集文本数据,还可批量下载各类文件,并支持自定义保存路径和文件名规则。
数据过滤:提供高级过滤功能,可直接清理采集结果并屏蔽不必要的数据。
多样化导出:数据可直接导入指定数据库,甚至通过API接口发布到您自己的网站。
5️⃣ 爬山虎采集器怎么用
一、如何使用【简易模式】采集数据
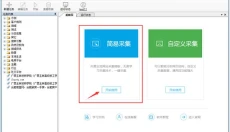
第一步:打开客户端,选择简易模式
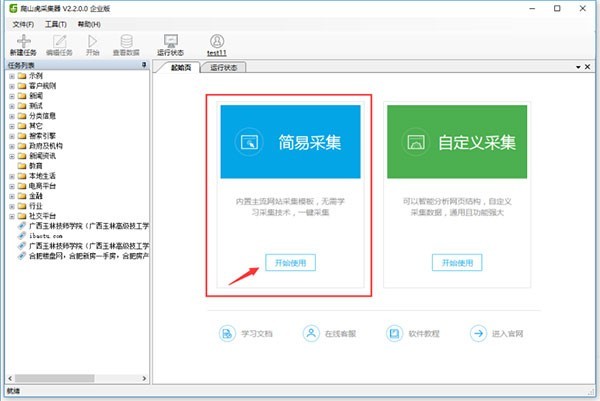
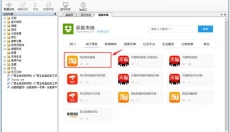
选择相应的采集模板
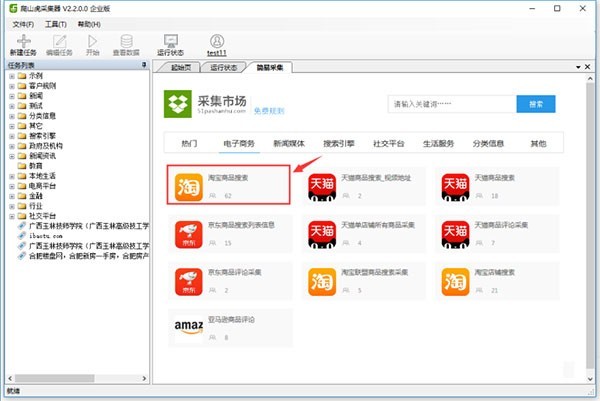
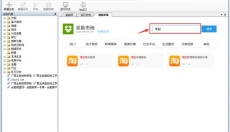
也可以根据入关键词搜索,筛选对应的模板分类
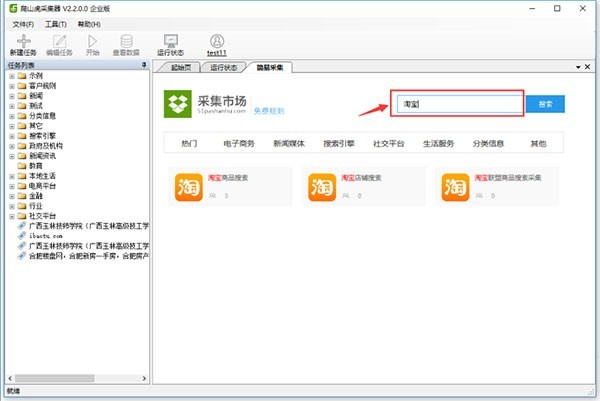
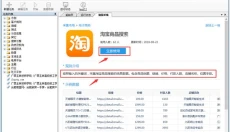
第二步:预览模板的采集字段和示例数据
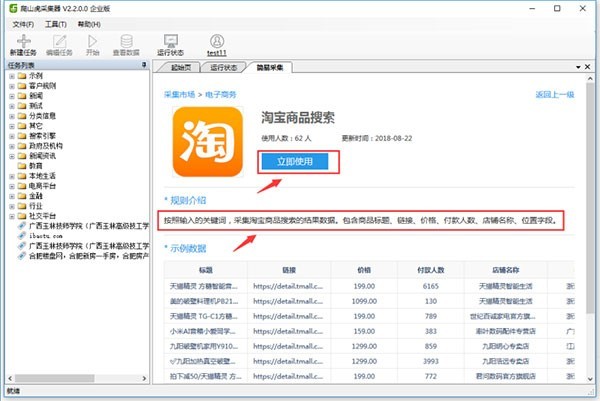
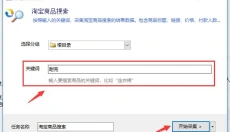
根据提示,输入对应的参数(此模板是输入需要采集的关键词)
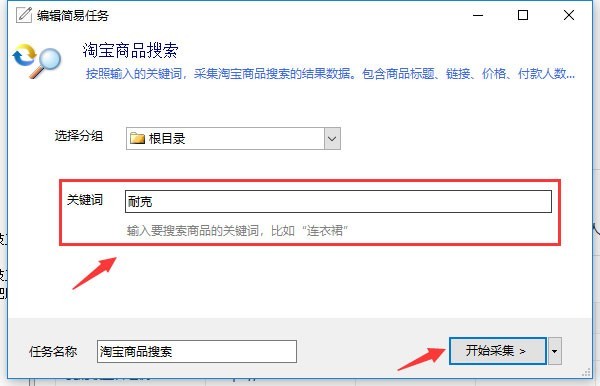
第三步:运行并下载
开始即可查看加载的进程
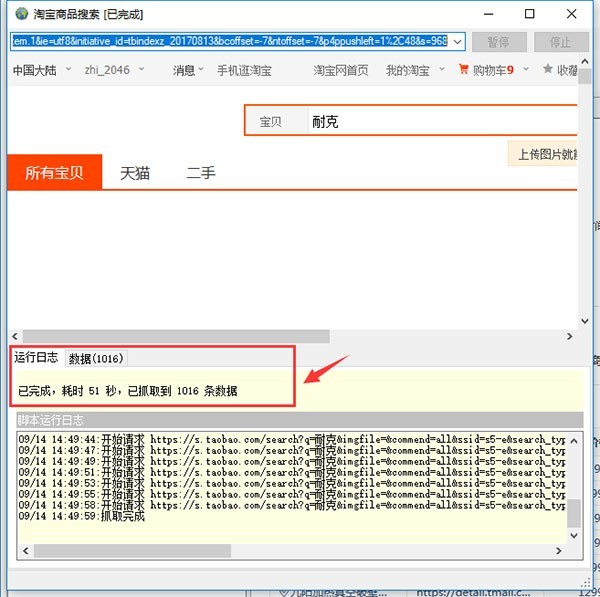
任务列表中:选中任务/点击查看
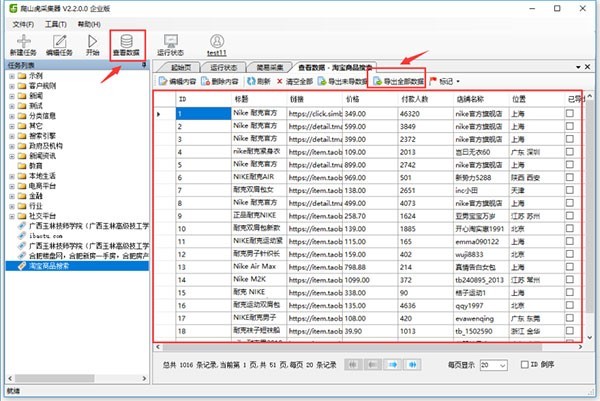
选择合适的保存格式
二、如何使用高级过滤,筛选关键词采集数据
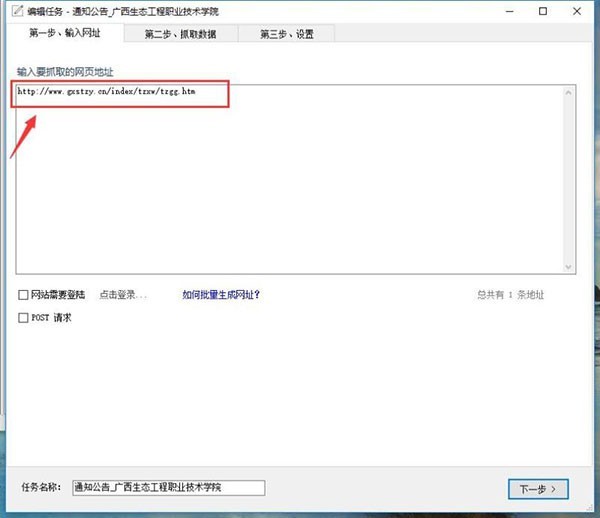
第一步:新建任务,进入主页,选择“新建任务”输入需要采集的网址。
第二步:抓取数据
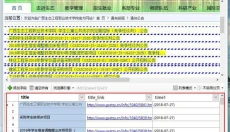
采集器自动识别列表数据 自动识别分页(需要采集多页数据)
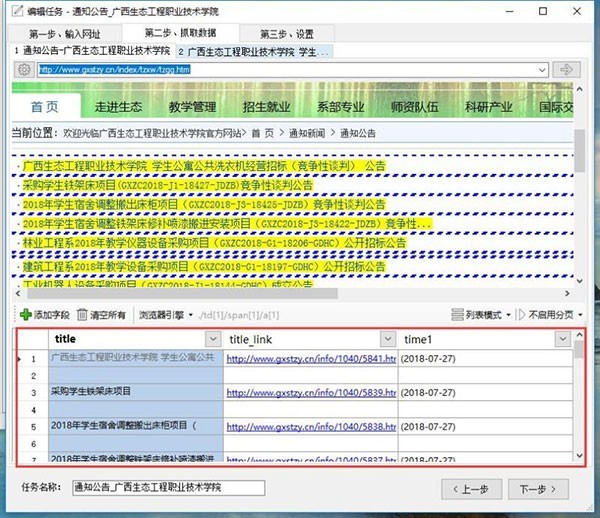
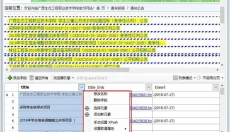
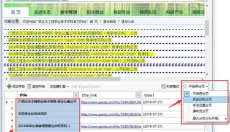
点击标题列/右键/高级过滤(可以根据需求自定义添加删除字段,修改名称等)
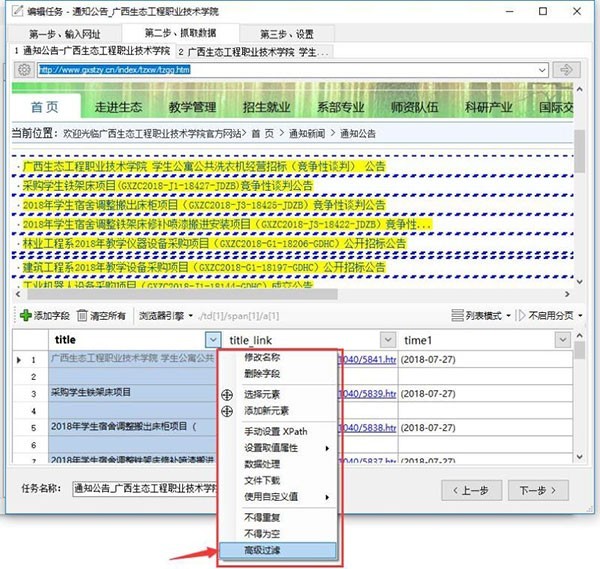
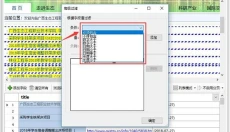
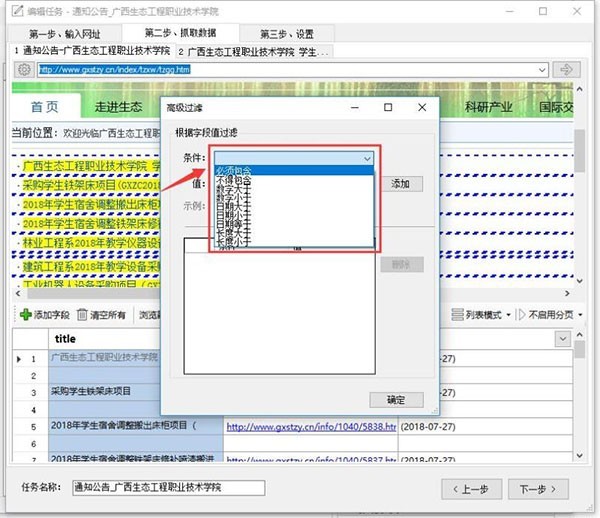
必须包含
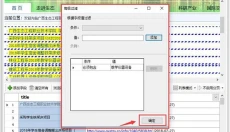
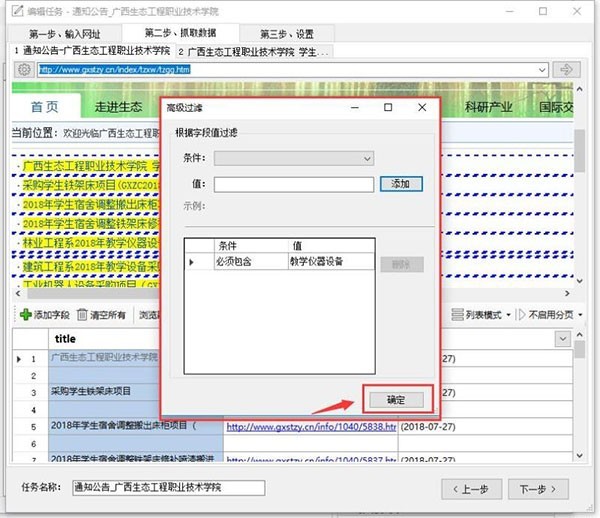
输入关键词:教学仪器设备,添加确定即可
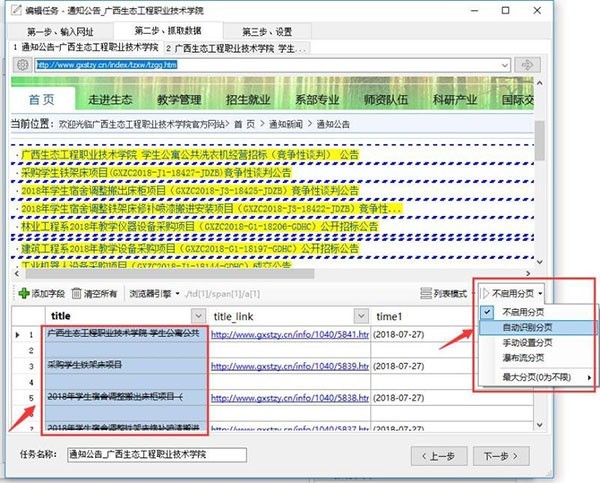
可以看到,不包含关键词的名称已删除,需要采集多页:自动识别分页
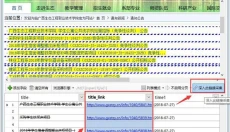
选中链接/深入此链接(需要采集关键词的内容页)
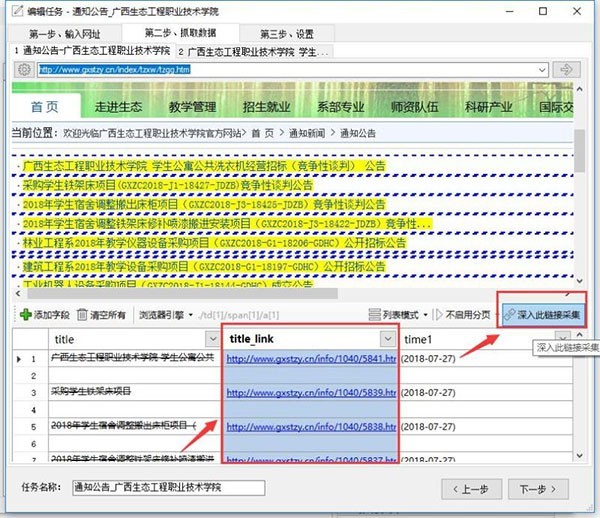
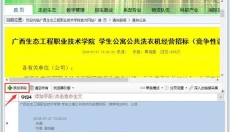
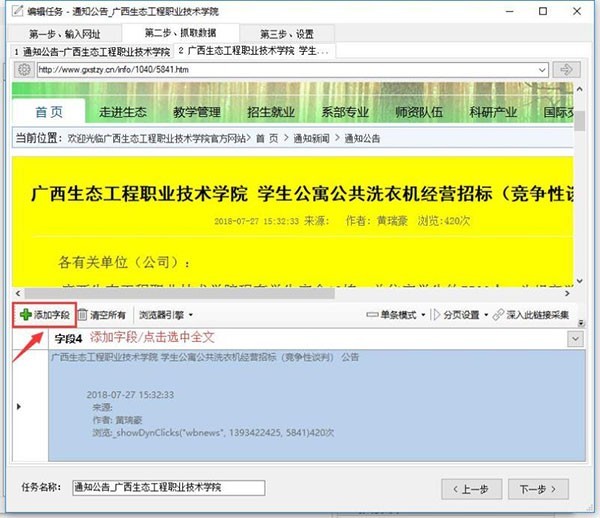
添加字段/点击选中全文
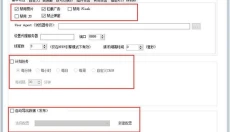
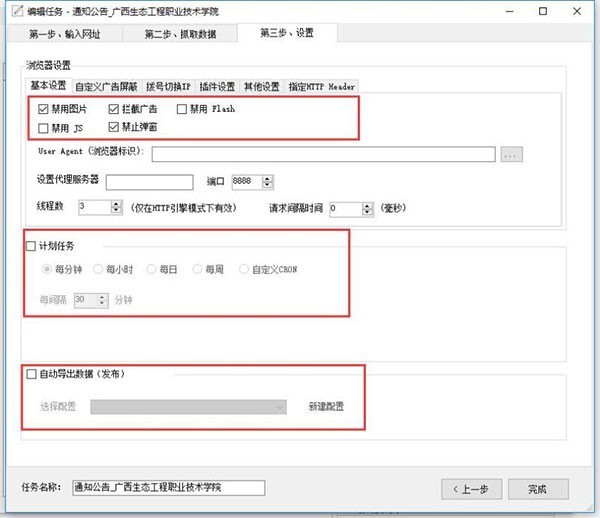
第三步:设置 根据需要,自定义设置,可以大大提高加载速度及工作效率。
第四步:加载数据 任务列表中:选中任务/点击开使
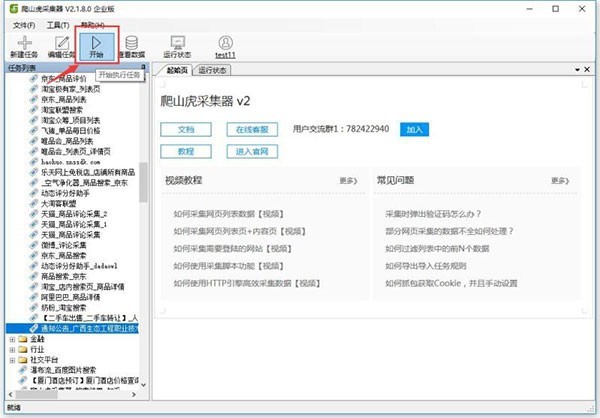
可以看到加载的进程 (点击数据也可以查看刚加载的数据)
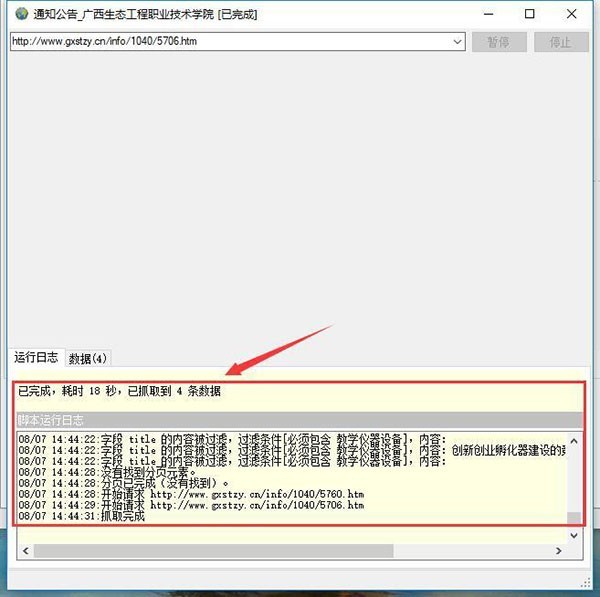
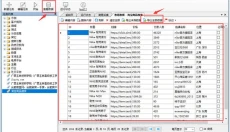
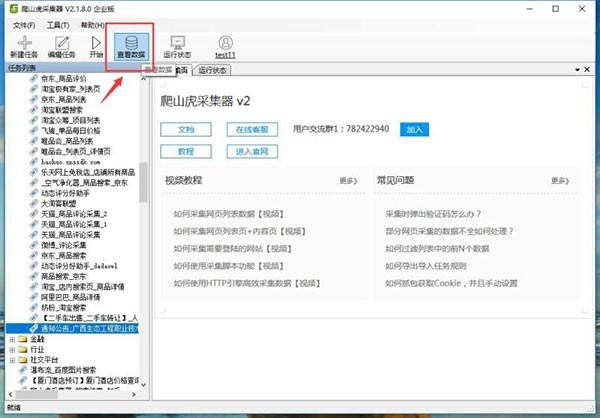
第五步:查看保存数据 任务列表中:选中任务/点击查看
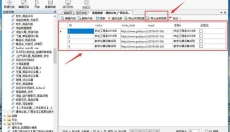
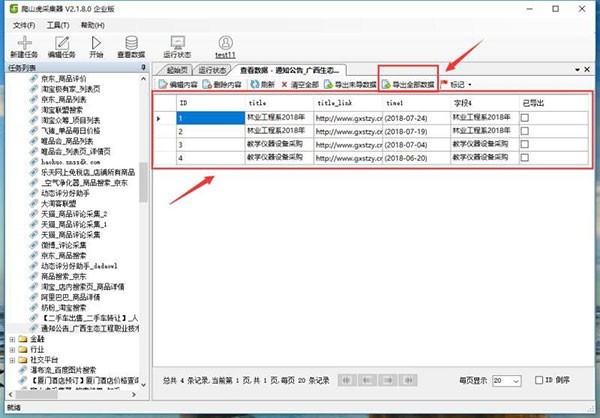
可以预览刚加载的数据,并导出数据
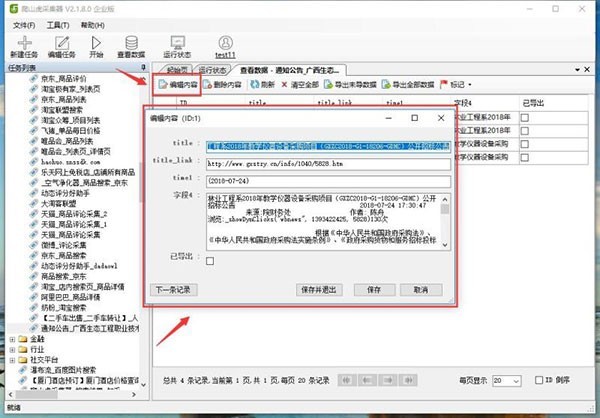
特殊情况 :编辑内容,可以预览全部数据(修改后统一下载 )
6️⃣ 爬山虎采集器软件测评
爬山虎采集器软件内容多样,操作简单在不同的设备中都可以使用,这里的参数内容和型号多样,用户可以抓取各种网页资源和内容,去采集不同的网页资源下载使用,帮助用户去采集不同的文件,享受软件带来的服务。
7️⃣ 爬山虎采集器更新日志
v5.0.2.1
兼容chrome新版的curl格式
修复部分单页网站的深入采集
修复部分iframe采集问题